售前顾问一对一沟通
获取专业解决方案
判断一个 Agent 平台是否可用,看两件事——推理引擎怎么"想"、上下文怎么"喂"。纷享销客AI技术平台ShareHive 的选择是:以 Code Agent 为内核、以 ReAct Loop 为机制,再在上下文的通用压缩与领域注入上做两层构建。
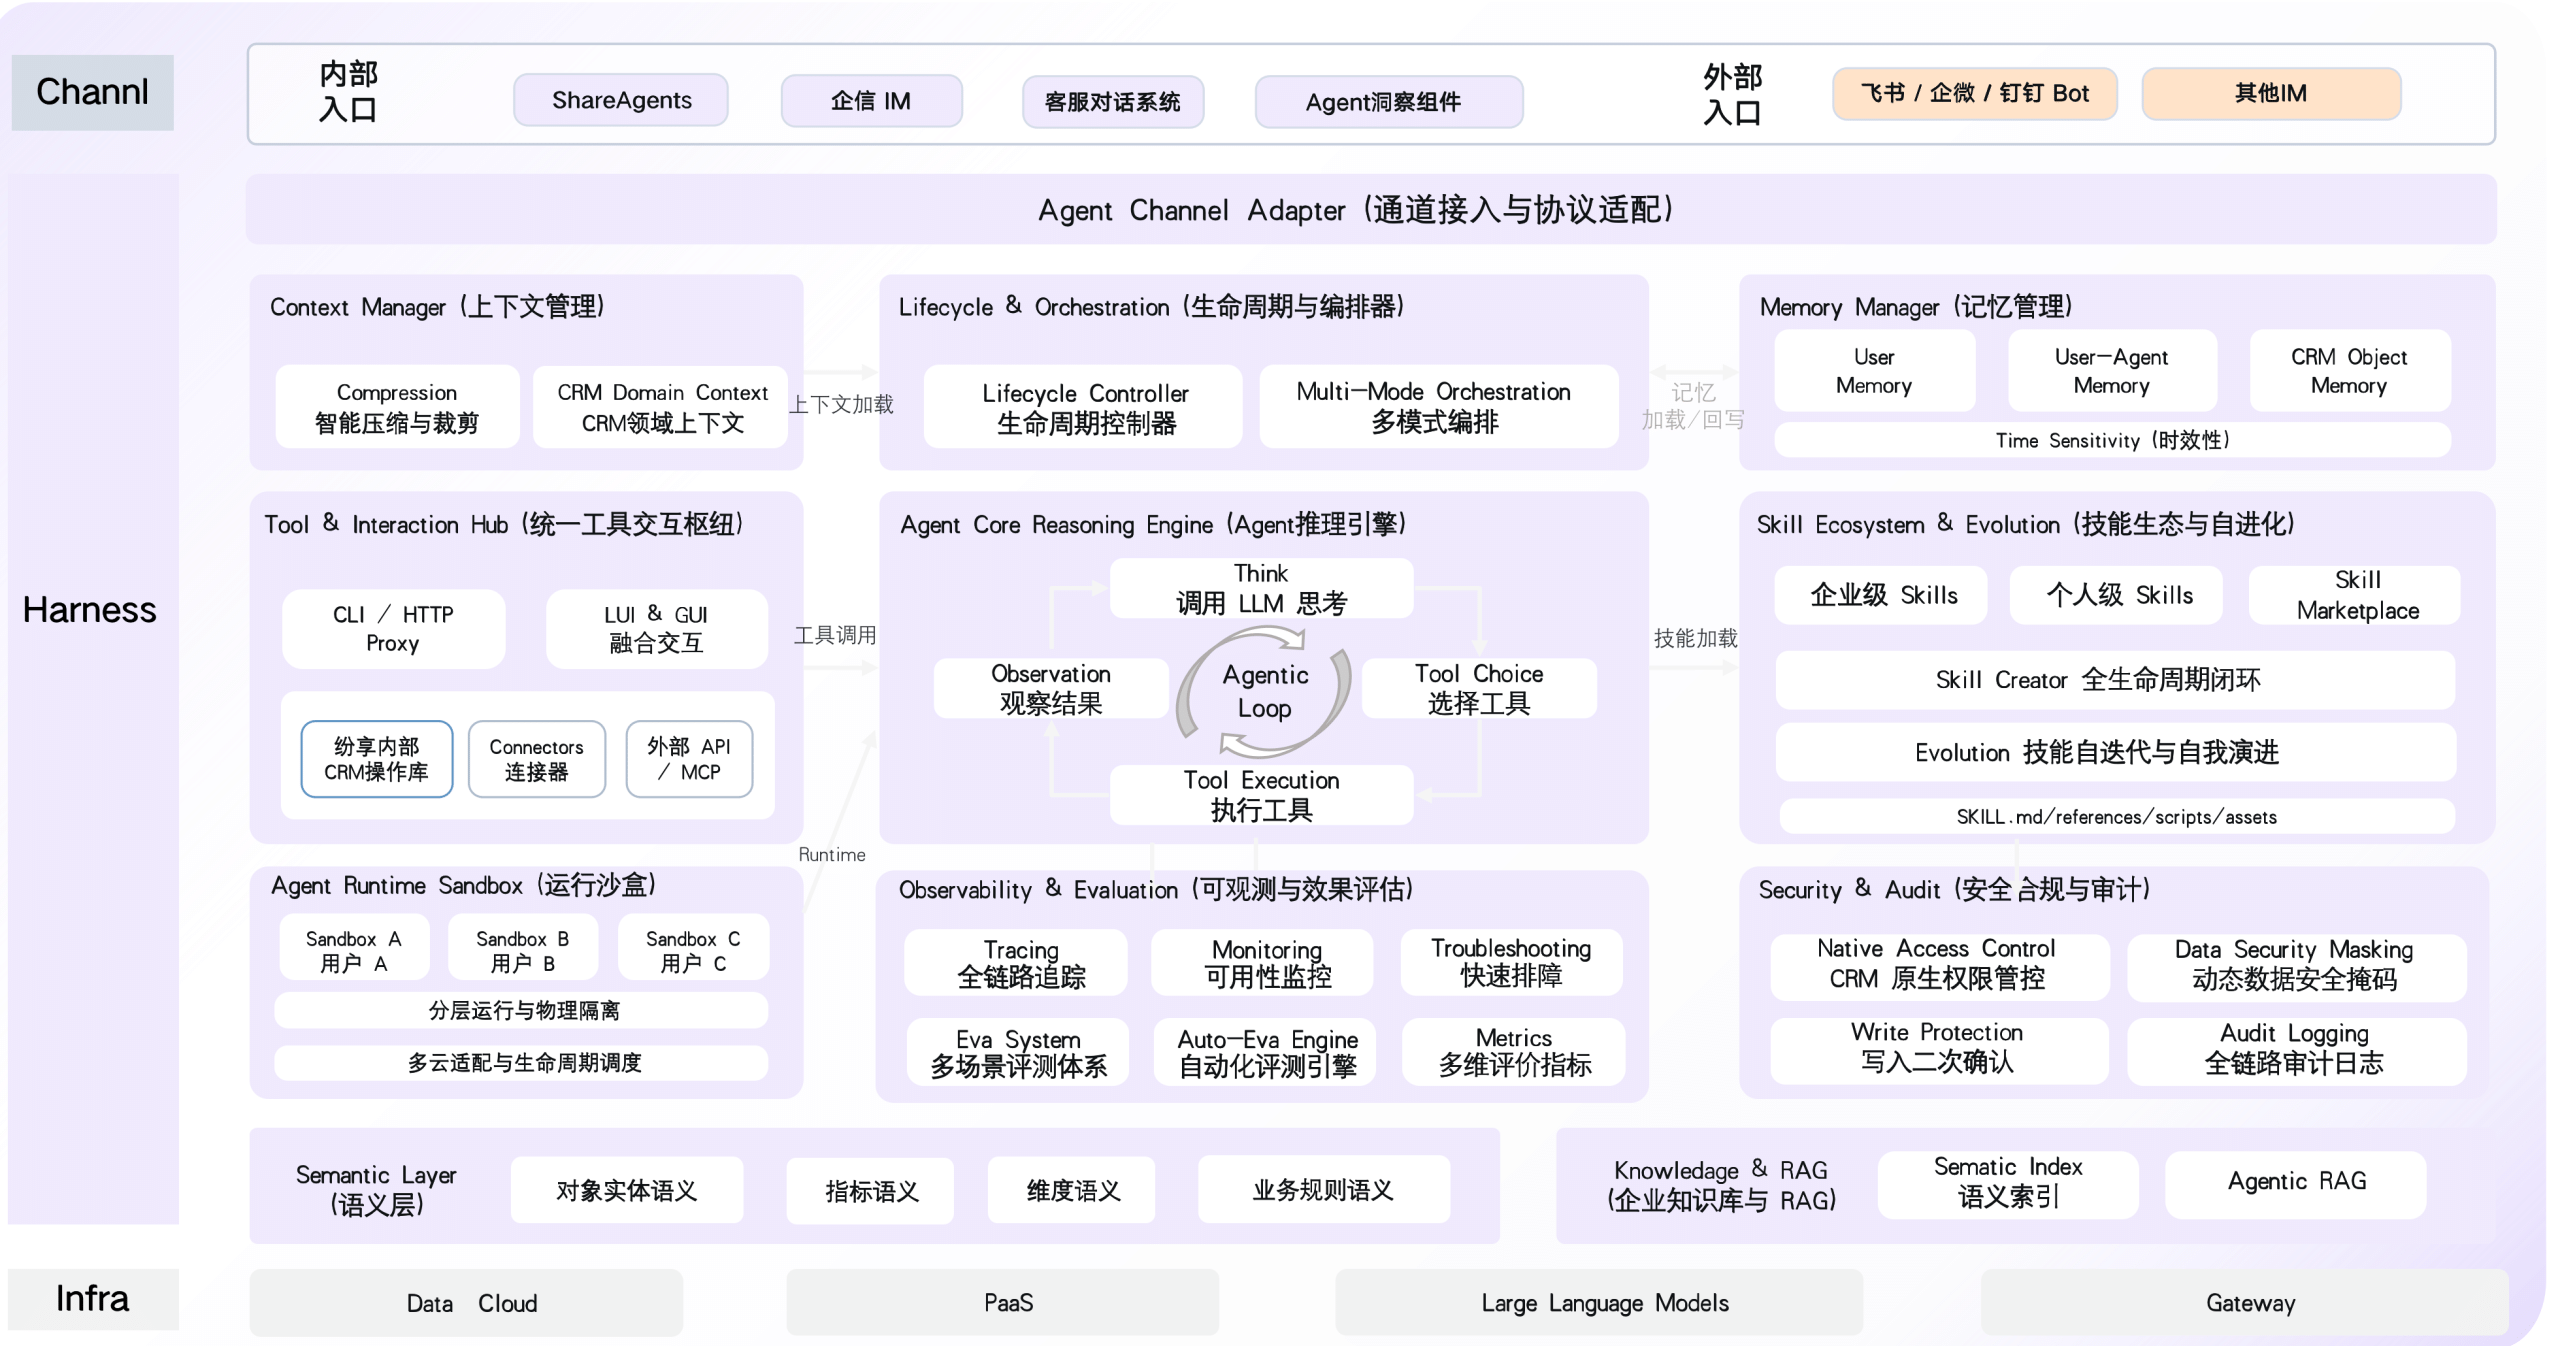
纷享销客AI技术平台ShareHive 的推理引擎以 Code Agent(代码智能体)作为内核,并通过扩展方式在其上构建了 CRM 领域的各类工具与 SubAgent。
相较传统的、当代流程式的 Agent,这一推理引擎的根本区别在于:它以 ReAct 作为核心机制。

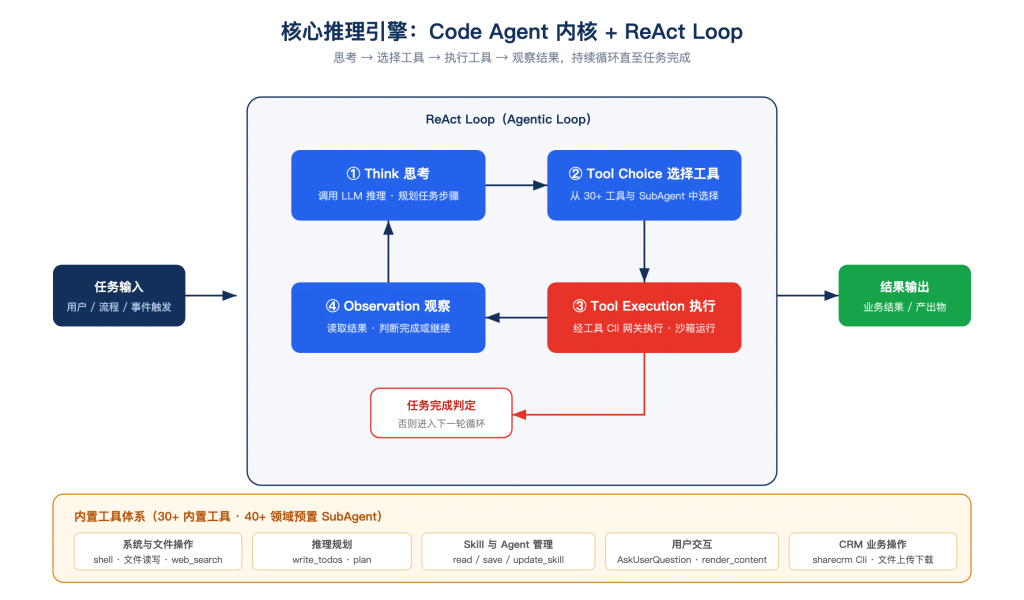
当一个任务进来之后,Agent 会先思考(Think),然后选择工具(Tool Choice),执行工具(Tool Execution),拿到结果后观察(Observation),再进入下一轮思考,判断任务是已完成还是需要继续选择工具——持续通过 ReAct Loop 的方式推进,直至任务完成。
每一轮的"观察"必须是真的业务结果,而不是模型编出来的结果;
每一轮的工具选择必须在权限边界内,不能"想办法绕过";
循环必须能收敛,不能在一次长任务里无限打转;
循环必须能被打断和恢复,因为企业任务往往要跨越数小时甚至数天。
也正因如此,纷享销客AI技术平台ShareHive 的引擎不是"一个会调用工具的模型",而是围绕这个循环补齐了一整套企业级调度能力。
引擎在架构上开放了 30+ 预制工具与 40+ 领域预置 SubAgent,工具体系包括:
系统与文件操作工具:shell、read_file / write_file / edit_file / file_parse、web_search / web_fetch 等通用能力;
推理规划工具:write_todos、plan 等任务规划与拆解能力;
Skill 与 Agent 管理工具:read_skill / save_skill / update_skill,以及 Agent / Expert 的自身管理工具;
用户交互工具:AskUserQuestion(向用户提问澄清)、render_content(将产出物推送给用户)等;
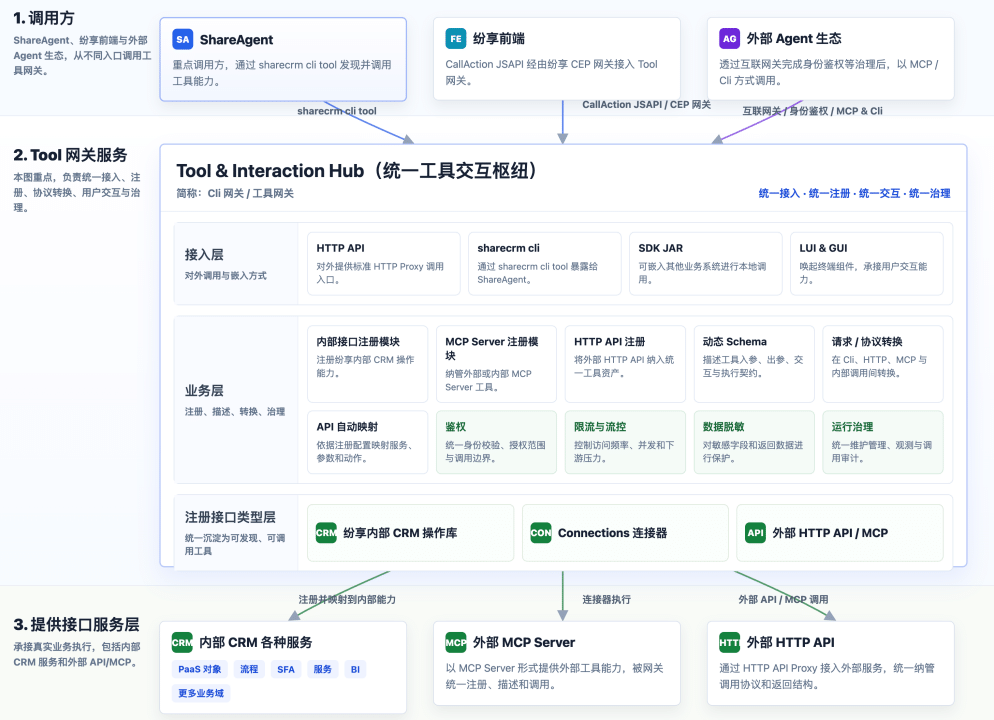
CRM 业务操作工具(最关键):通过 sharecrm Cli 以 CRUD 方式,经工具 Cli 网关操作纷享内的各类数据与业务,甚至调度流程、访问文件系统,对文件进行上传下载——文件在沙箱本地处理完成后,会自动上传回流,挂接到 CRM 系统内。
值得单独说的是最后一类。多数 Agent 产品的"业务能力"止步于读写接口,而这里的 Agent 可以调度流程、可以动文件,处理完还能回流到 CRM。这意味着 Agent 能够完成的是"一件事",而不是"一次问答"。
在此之上,引擎还具备企业级调度能力:
多智能体协作:同步阻塞、异步回调、Fire-and-Forget 三种混合调度模式,主从 Agent 间通过消息总线共享任务上下文;
超长任务断点存盘与恢复;
异常降级与指数退避重试;
并发配额管控:基于租户与任务优先级;
深度人机协同(Human-in-the-Loop):Agent 遇到高价值决策时自动进入交互状态等待人工确认,并可监听 CRM 业务对象变化实现"业务驱动式挂起与唤醒"。
"业务驱动式挂起与唤醒"是个容易被忽略的设计。它意味着 Agent 不必一直占着算力等一个业务状态变化——比如等合同审批通过、等客户回款到账——而是可以先挂起,等对象变化再被唤醒。企业业务本来就是异步的,Agent 的运行模型也必须异步。
任何一个通用 Agent 平台都必须具备上下文管理能力,纷享销客AI技术平台ShareHive 在此之上做了两层构建。
第一层是通用上下文的智能压缩与裁剪。无论大模型上下文窗口是 200K 还是 1M,其真正高效的上下文区间实际上有限——观察发现,当上下文膨胀超过 300K–500K 后,模型的自注意力机制对关键信号的敏感度会明显下降,推理效果大幅衰减。因此必须在运行态进行智能压缩:
Token 预算监控与阈值驱逐:触达阈值时触发上下文压缩,优先剥离较早轮次的低价值工具执行结果,尽量保留 Agent 的推理过程,保证逻辑链条不断裂;
工具动态卸载:将长时间不用的工具定义从上下文中卸载,按需再加载;
精细化压缩策略:按工具类型、时效性,结合 KV Cache 命中情况,对低价值数据进行个性化裁剪,让上下文对 Agent 的效率与价值最大化;
工具级 Payload 裁剪:针对单次返回极大的 API 数据,支持按需提取,避免单次调用撑爆上下文。
注意第一条的取舍逻辑:剥离的是"低价值工具执行结果",保留的是"推理过程"。这是一个明确的价值判断——模型需要知道自己为什么这么做,但不需要记住三个月前某次查询返回的完整报文。
第二层是 CRM 领域上下文的精准注入。这是 纷享销客AI技术平台ShareHive 区别于通用平台的关键——把 CRM 领域数据注入上下文,让 Agent 运行时更懂当前业务场景:
静态注入:用户进入线索详情页、商机列表页等具体页面时,当前核心实体的元数据(Record ID、操作人、页面标识)自动注入上下文。用户在客户详情页直接问"当前客户情况怎样",Agent 自然知道说的是哪条客户数据;
动态装配:Agent 执行特定业务 Skill 时,上下文模块根据静态 ID 并行向 DataCloud 拉取延伸数据,自动补充深度业务背景;
语义化翻译:CRM 底层数据喂给大模型前,经过语义清洗拦截器,将不可读的系统标识(API 字段名、字典键值)翻译为大模型易于理解的业务显示值,避免在无意义标识符上产生幻觉;
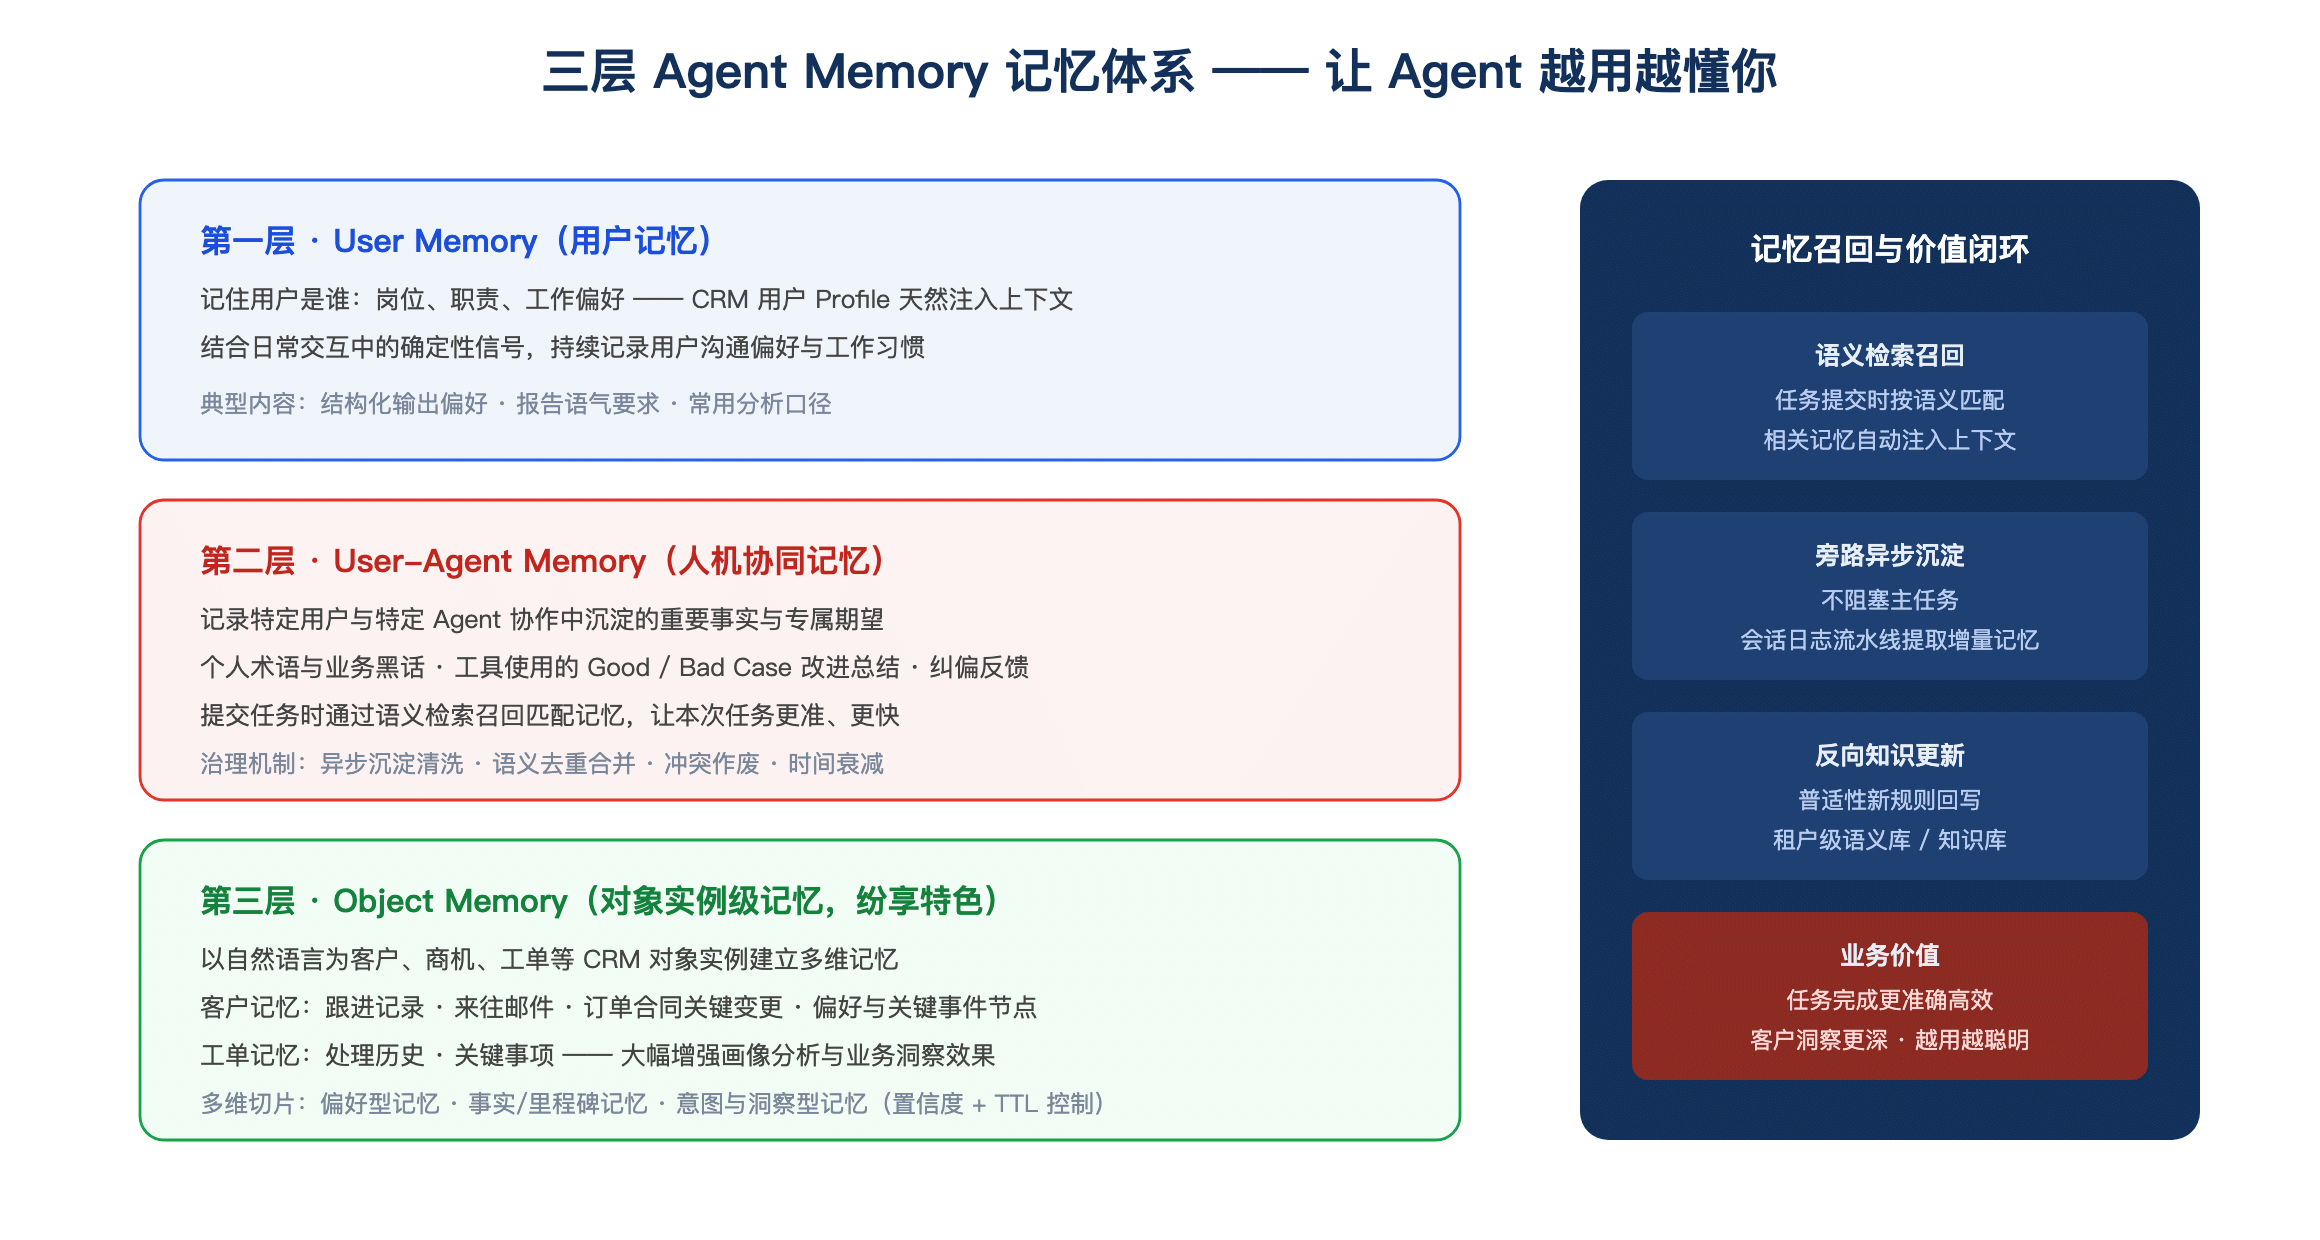
Memory 注入:三层 Memory 中匹配的记忆,同样通过上下文管理注入,让 Agent 得到更精确的数据。
这四件事解决的是同一个问题:用户不会把上下文说全。业务人员说的是"这个客户""这单",Agent 必须自己从页面、从对象、从记忆里把上下文补齐。补齐得越准,模型需要"猜"的地方就越少,幻觉也越少。
推理引擎决定 Agent 的上限,上下文管理决定 Agent 的稳定性,纷享销客AI技术平台。纷享销客 ShareHive 的做法是把两者绑在一起:ReAct Loop 负责一轮轮推进,上下文管理负责每一轮都拿到足够准确、足够干净的信息,中间由权限、沙箱、调度、人机协同兜住企业级要求。这套组合,才是"能工作"三个字的技术解释。
阅读下一篇